
Il y a encore quelques années, écrire du code coûtait cher et le relire coûtait raisonnablement peu. Aujourd'hui, la balance basculé : un assistant génère en quelques secondes ce qu'un développeur écrivait en une heure, mais relire ce code demande toujours le même temps, voire plus. Le goulot d'étranglement s'est déplacé de l'écriture vers la revue.
Quand une partie du code est générée, la question n'est plus seulement « est-ce que ça marche ? » mais « qu'est-ce que je dois vraiment vérifier, et qu'est-ce que je peux laisser aux outils ? ». Cet article propose une méthode pour y répondre.
Ce qui change vraiment avec le code généré
Le code est plausible par construction. Un modèle produit du code propre, bien nommé, souvent commenté, qui a l'air juste. C'est précisément le danger : la forme rassure, alors que le fond peut être faux. Un code maladroit alerte le relecteur ; un code élégant et incorrect l'endort.
Le volume augmente. Les PR sont plus grosses, plus fréquentes. Le risque est de glisser vers le "c'est bon pour moi" réflexe par simple fatigue.
L'auteur n'a pas toujours tout lu. Avec du code écrit à la main, l'auteur a forcément réfléchi à chaque ligne. Avec du code généré, il peut avoir accepté une suggestion sans la comprendre entièrement. Le relecteur devient parfois le premier humain à lire sérieusement le code.
Les erreurs ont une signature différente. Un humain se trompe souvent sur la logique ou oublie un cas. Un modèle, lui, peut inventer une fonction ou un paquet qui n'existe pas, mélanger les conventions de deux versions d'une bibliothèque, ou résoudre un problème légèrement différent de celui posé.
Ce qui ne change pas
La responsabilité reste celle de l'auteur de la PR. Peu importe qui a tapé les lignes : la personne qui ouvre la pull request en répond comme si elle les avait écrites. Cette règle simple évite le piège du « c'est l'IA qui a fait ça ». C'est aussi un bon principe à poser noir sur blanc dans les règles de l'équipe.
Étape 1 : laisser les machines faire ce qu'elles font bien
Un relecteur humain ne devrait jamais perdre du temps sur ce qu'un outil détecte. Avec du code généré, cette automatisation devient encore plus importante :
- formatage et style (formateur et linter dans la CI)
- typage statique et compilation
- tests automatisés, avec un seuil minimal de couverture sur le code modifié
- analyse de sécurité et audit des dépendances
- détection de secrets committés par erreur.
Si la CI est verte, le relecteur peut consacrer son attention à ce qu'aucun outil ne voit.
Étape 2 : relire l'intention avant le code
Avant d'examiner une seule ligne, posez-vous la question : est-ce le bon problème qui est résolu, de la bonne façon ?
Un modèle répond à la demande qu'on lui a faite, pas forcément à celle qu'on aurait dû lui faire. Lisez la description de la PR, le ticket associé, et demandez-vous si l'approche est cohérente avec l'architecture existante. Si la description est vide ou vague, c'est déjà un signal : renvoyez la PR à son auteur.
Étape 3 : chasser les hypothèses implicites
C'est là que se cachent la plupart des bugs du code généré. Le modèle fait des choix silencieux : que la liste n'est jamais vide, que la date est en UTC, que l'appel réseau réussit, que l'utilisateur est authentifié.
Pour chaque bloc de logique, demandez :
- Que se passe-t-il avec une entrée vide, nulle, très grande, mal formée ?
- Que se passe-t-il si l'appel externe échoue ou expire ?
- Que se passe-t-il en cas d'accès concurrent ?
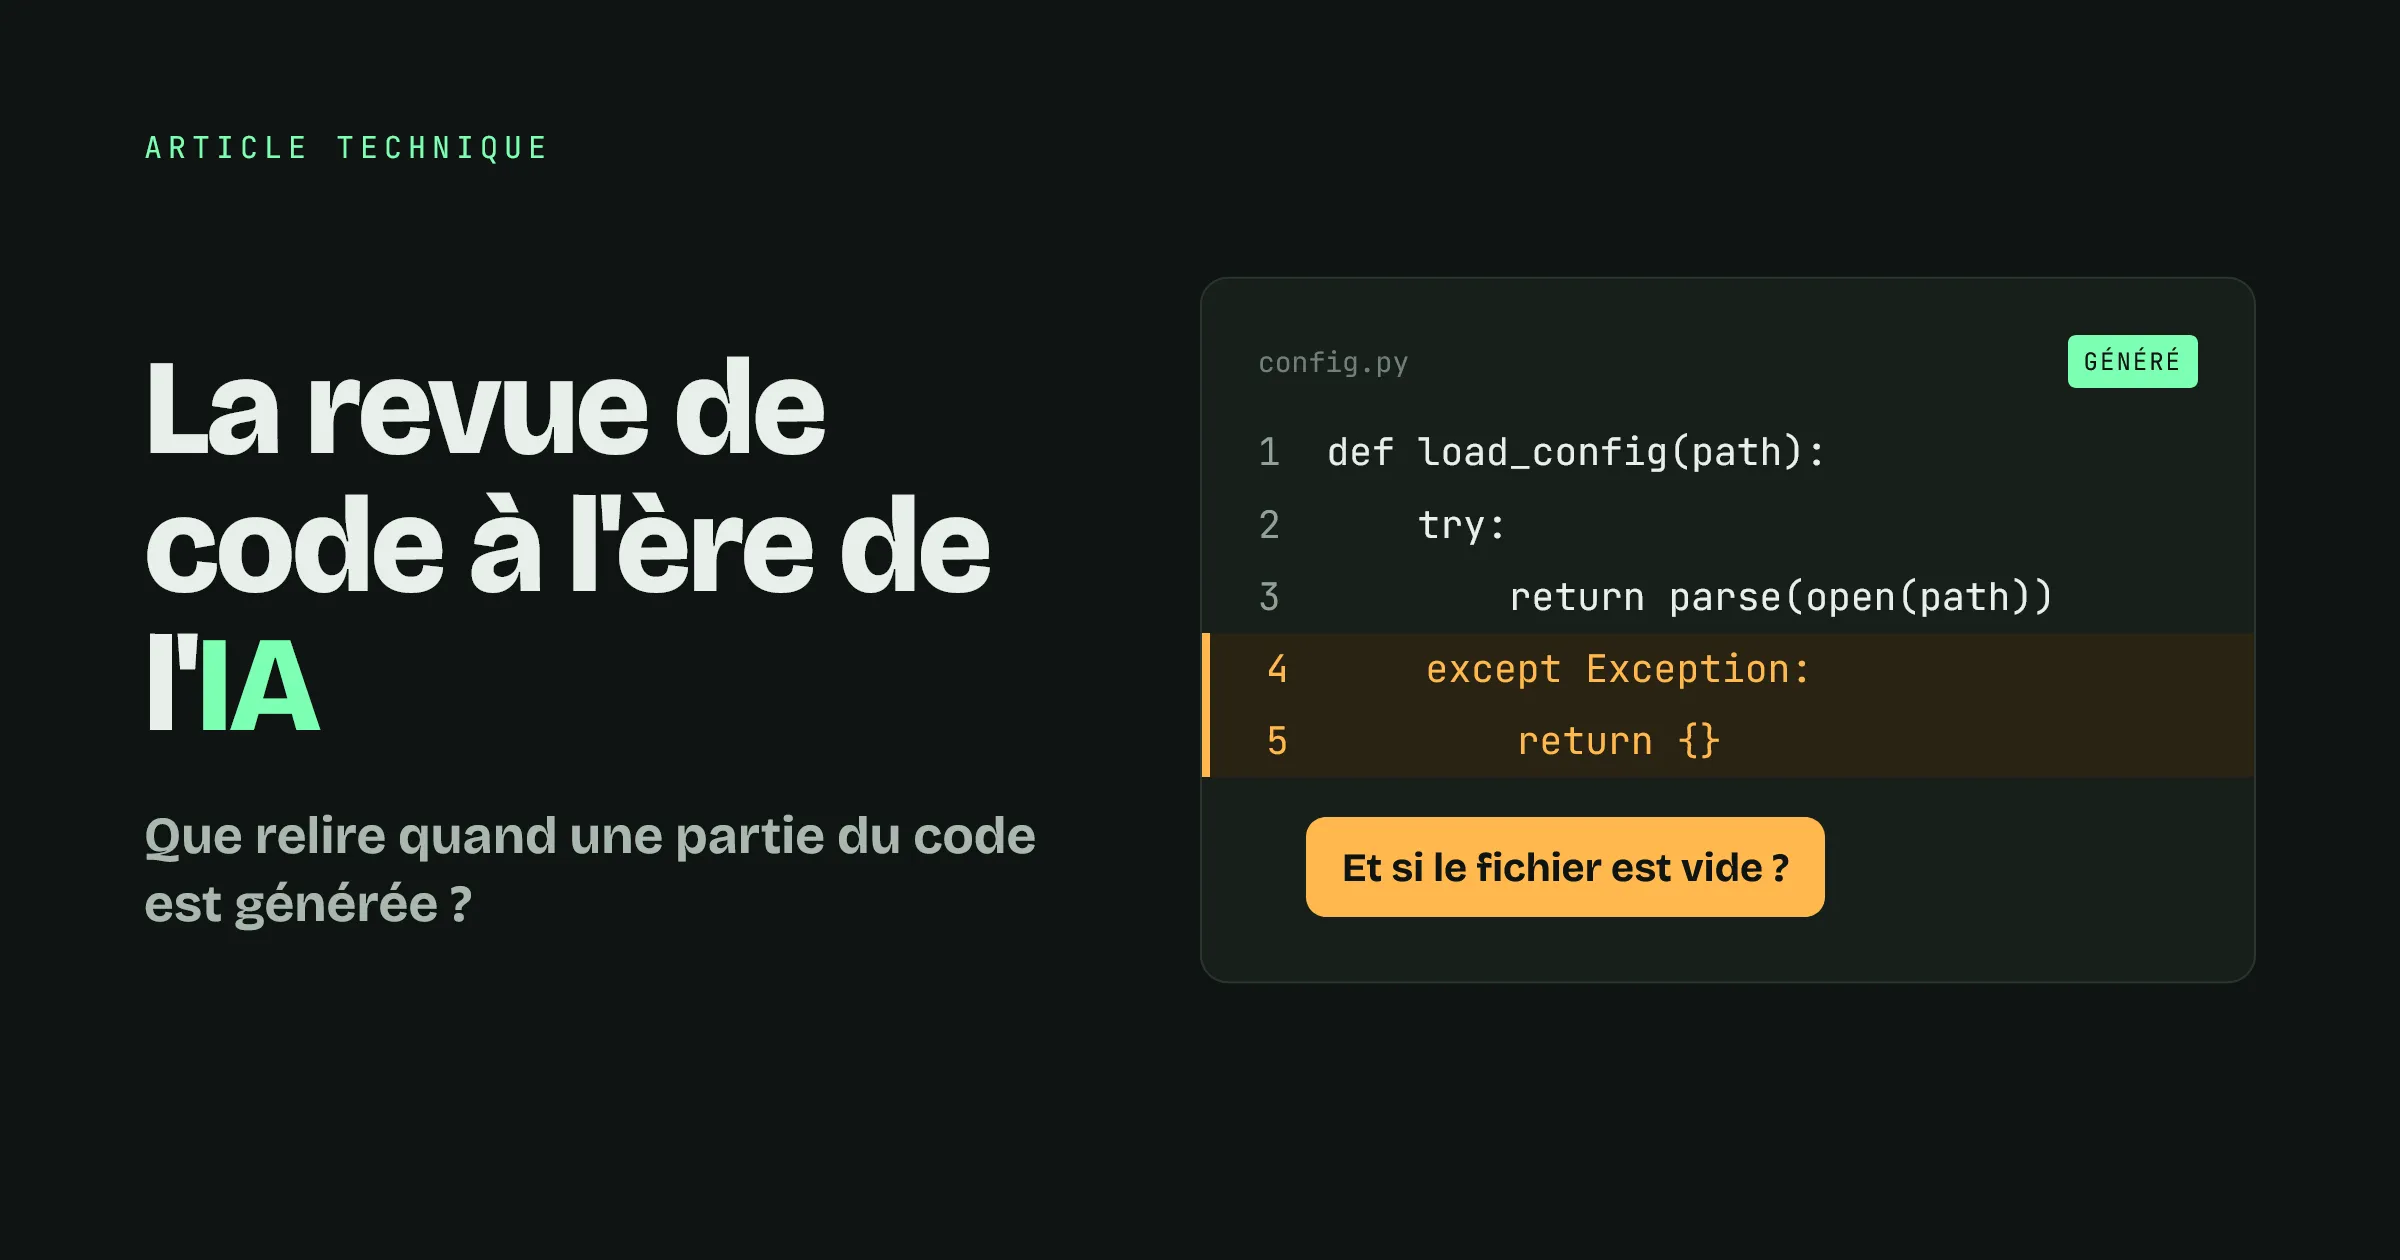
- Les erreurs sont-elles gérées, ou simplement avalées par un
try/catchlarge qui masque le problème ?
Étape 4 : vérifier l'existence et la pertinence des dépendances
Les modèles peuvent référencer des fonctions, des options ou des paquets qui n'existent pas, ou qui existent dans une autre version. Vérifiez :
- que chaque nouvelle dépendance existe réellement, qu'elle est maintenue et qu'elle est nécessaire ;
- que les API utilisées correspondent à la version installée dans le projet ;
- que le nom du paquet est bien le bon (le piège du paquet au nom proche d'un paquet légitime est une vraie vulnérabilité de chaîne d'approvisionnement).
Étape 5 : traquer la duplication et l'incohérence avec l'existant
Un modèle ne connaît que ce qu'il a dans son contexte. Il réécrit volontiers une fonction utilitaire qui existe déjà trois dossiers plus loin, ou adopte un style de gestion d'erreurs différent de celui du reste du projet.
Posez-vous la question : est-ce qu'on avait déjà ça ? Est-ce que ça suit nos conventions ? Ce travail de mémoire collective est typiquement humain, et c'est l'un des apports les plus précieux d'un relecteur qui connaît la base de code.
Étape 6 : examiner les tests avec méfiance
Les tests générés posent un piège subtil : ils sont souvent écrits à partir du code, donc ils valident ce que le code fait, pas ce qu'il devrait faire. Un test qui passe n'est pas une preuve de justesse.
Vérifiez que les tests :
- couvrent les cas limites et les cas d'erreur, pas seulement le chemin nominal ;
- contiennent de vraies assertions (pas juste « la fonction ne plante pas ») ;
- échoueraient réellement si le comportement était cassé. Une astuce : modifier volontairement le code et voir si un test devient rouge.
Étape 7 : se méfier de la complexité inutile
Le code généré a tendance à être verbeux : abstractions prématurées, couches superflues, options que personne n'a demandées. Moins de code est presque toujours meilleur. N'hésitez pas à demander : « peut-on faire plus simple ? »
Un exemple de commentaires utiles
Deux formulations pour la même remarque, sur une fonction qui parse un fichier de configuration :
- ❌ « Je ne comprends pas ce code, peux-tu le réécrire ? »
- ✅ « Que se passe-t-il si le fichier est vide ou si la clé
timeoutest absente ? Ici lecatchlarge renvoie une config par défaut sans rien logguer, on risque de masquer une erreur de déploiement. Peux-tu lever une erreur explicite et ajouter un test pour ce cas ? »
Le second commentaire est précis, actionnable et pointe une hypothèse implicite plutôt que de critiquer la personne.
Ce qu'on attend de l'auteur de la PR
La qualité de la revue dépend aussi de ce qui est livré au relecteur. Quelques règles à instaurer :
- Se relire soi-même d'abord. Si l'auteur n'a pas lu le code généré, le relecteur ne doit pas être le premier à le faire.
- Garder les PR petites. Une PR de 800 lignes générées ne sera pas relue correctement, quelle que soit la bonne volonté.
- Expliquer le pourquoi. Un code généré ne dit pas pourquoi ce choix a été fait ; la description de la PR doit le dire.
- Signaler les zones générées et peu maîtrisées. Dire « cette partie vient d'un assistant, je suis moins sûr de la gestion des erreurs ici » oriente intelligemment l'attention du relecteur.
Et la revue par une IA ?
Faire relire du code par un modèle est utile : il repère bien les oublis évidents, les incohérences de style, certaines failles courantes. Mais c'est un complément, pas un remplacement. Un modèle relisant du code produit par un modèle partage souvent les mêmes angles morts. Il ne connaît pas non plus l'historique de vos décisions, vos contraintes métier ni la dette que vous avez choisi d'accepter. Utilisez-le comme premier filtre, pas comme dernier mot.
Le piège de la fatigue de revue
Le vrai risque n'est pas technique, il est humain : quand tout arrive vite et semble correct, on valide sans lire. Quelques garde-fous :
- limiter la taille des PR, quitte à refuser les trop grosses ;
- accepter qu'une revue sérieuse prenne du temps et le comptabiliser dans la planification ;
- alterner les relecteurs pour éviter qu'une seule personne devienne le goulot ;
- cibler l'attention sur les zones à risque (sécurité, données, paiement) plutôt que de relire tout avec la même intensité.
Checklist rapide
- La CI est-elle verte (lint, types, tests, sécurité) ?
- L'intention est-elle claire et le bon problème est-il résolu ?
- Les hypothèses implicites et les cas limites sont-ils traités ?
- Les dépendances et API utilisées existent-elles vraiment, dans la bonne version ?
- N'y a-t-il pas de duplication avec l'existant ou d'écart avec nos conventions ?
- Les tests vérifient-ils le bon comportement, et pas seulement l'existant ?
- Peut-on faire plus simple ?
En résumé
L'IA ne supprime pas la revue de code, elle la déplace. On relit moins la syntaxe, que les outils gèrent, et davantage l'intention, les hypothèses, l'intégration dans le système et la solidité des tests. Le relecteur n'est plus seulement un correcteur : il devient le garant du sens et de la cohérence d'un code que personne n'a entièrement écrit à la main.
La bonne question n'est donc plus « ce code est-il correct ? » mais « sait-on pourquoi il est correct ? ». Tant qu'un humain peut répondre à la seconde, la revue a rempli son rôle.
Commentaires
Connectez-vous en un clic pour rejoindre la discussion.